엔지니어링
Maia 300은 연산을 36%, 메모리 대역폭을 2.5배 늘렸다. 그 비율이 곧 설계의 주장이다
OCP Global Summit에서 공개된 Microsoft의 3세대 맞춤형 AI 가속기는 Maia 200보다 연산을 36%, 메모리 대역폭을 2.5배 끌어올렸다. 추론의 병목은 연산이 아니라 메모리라는 분명한 베팅이다. 그리고 이 칩은 Azure 고객에게 팔지 않는다 — 그 한 가지가 용도를 거의 다 말해준다.
 MAI
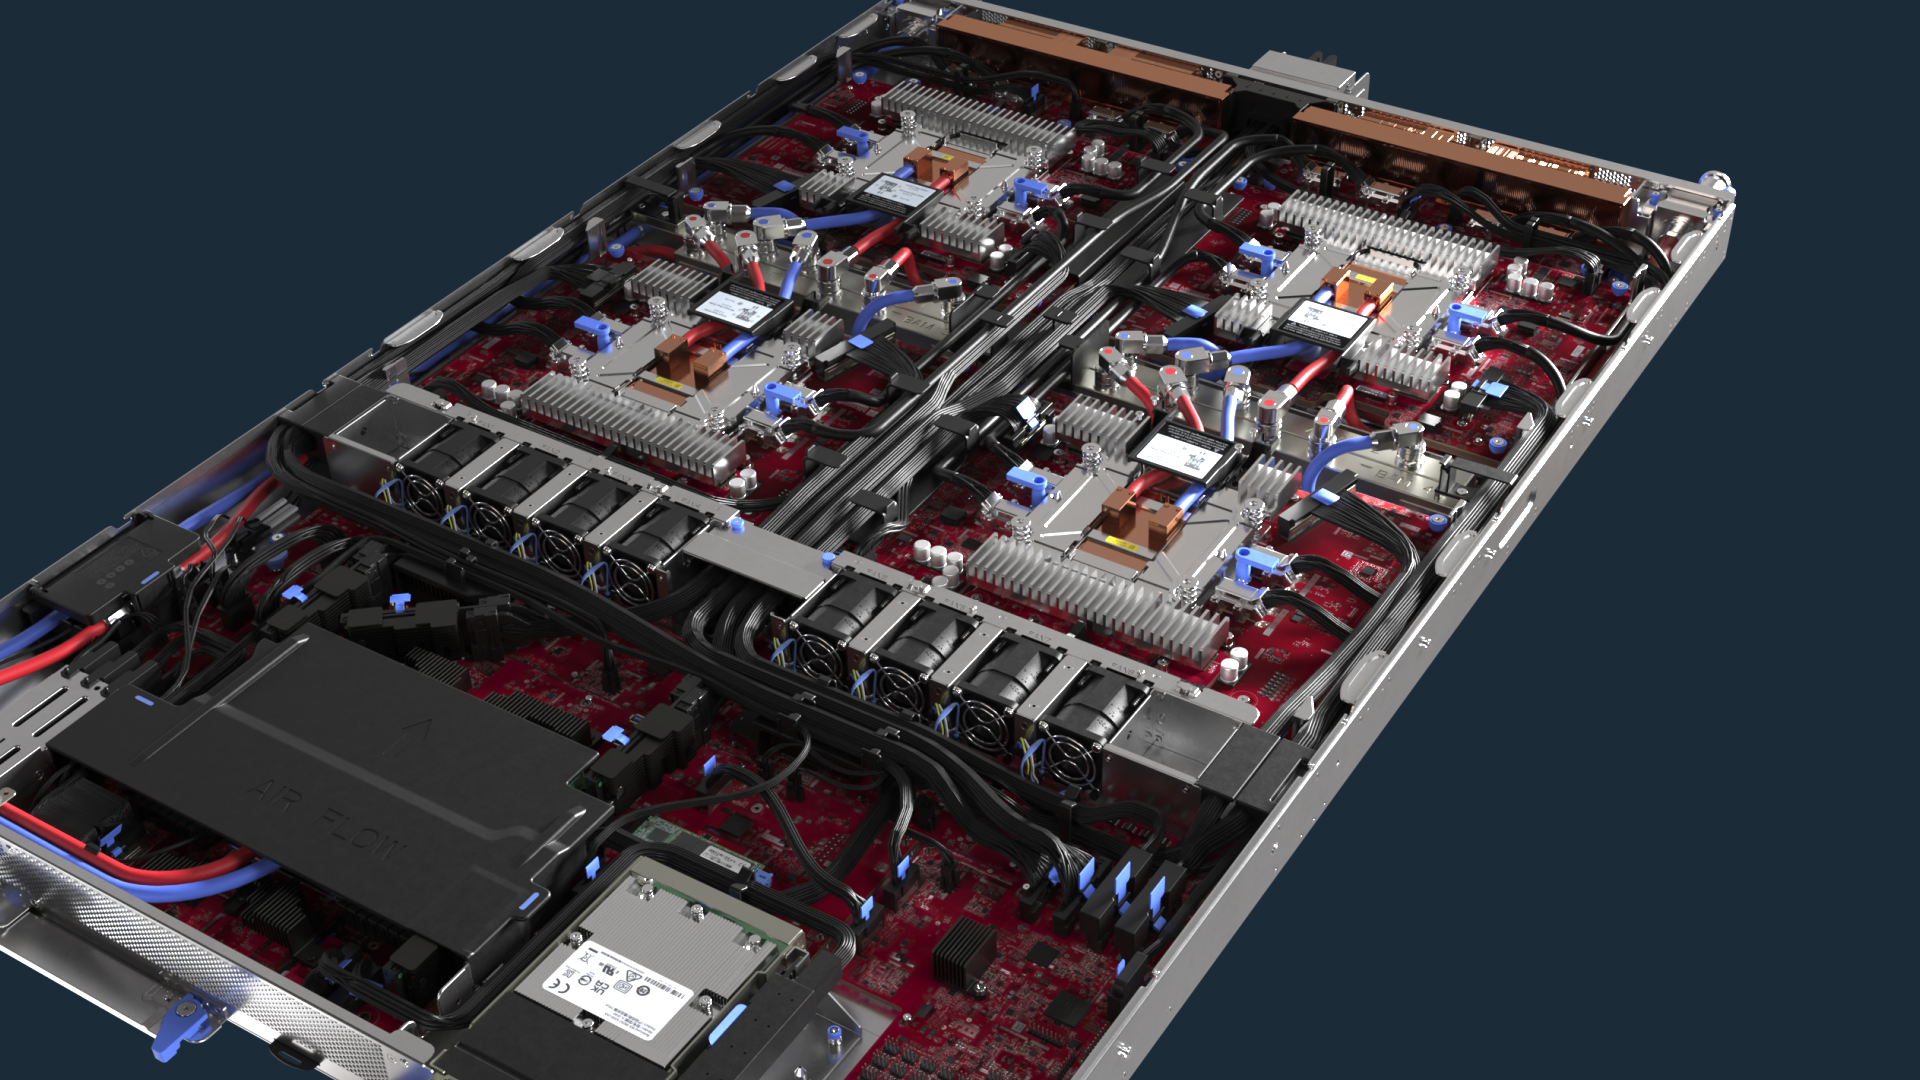
10월 12일 OCP Global Summit에서 공개된 Microsoft의 세 번째 맞춤형 AI 가속기는 그것이 대체하는 칩보다 연산 성능이 36% 높고, 메모리 대역폭은 2.5배다. 두 숫자는 Microsoft 자신의 자료에 나란히 적혀 있고, 그 둘 사이의 간격이 바로 설계다. Maia 300은 Nvidia를 연산량으로 넘어서려는 시도가 아니다. 데이터센터와 초당 토큰 수 사이를 막고 있는 것은 산술이 아니라, 가중치와 KV 캐시를 연산기 앞까지 끌어오는 속도라는 베팅이다.
이 베팅 자체는 새롭지 않다 — 지난 3년간 고대역폭 메모리가 희소 자원이었던 이유가 바로 그것이다 — 그러나 Maia 300은 그것을 바닥 도면 단계부터 중심에 두고 만든 첫 Maia다.
실리콘에서 무엇이 바뀌었나
Maia 300은 Microsoft의 첫 멀티 칩렛 Maia다. 연산 다이는 TSMC의 N2P 공정으로 옮겨가고, 메모리 컨트롤러와 I/O 기능은 별도 다이로 분리됐다. Microsoft는 이 다이들을 집적도가 아니라 대역폭과 비용에 맞춰 최적화했다고 설명한다. 메모리 주소 체계는 칩렛을 가로지르는 UMA에서 NUMA로 바뀌어, 데이터를 그것을 쓰는 연산기 옆에 둘 수 있게 됐다. 이만큼 넓게 퍼진 부품에서는 텐서가 어디에 놓여 있는지가 얼마나 빨리 곱해지는지만큼 중요하다는, 구조적인 인정이다.
| Maia 300 | Maia 200 | |
|---|---|---|
| 연산 다이 | TSMC N2P, I/O·메모리 다이를 분리한 멀티 칩렛 | N3P 모놀리식 다이 |
| HBM | HBM4 8스택 — 288 GB, 18 TB/s | HBM3E 6스택 — 216 GB, 7.1 TB/s |
| FP4 피크 | 13.8 POPS | 10.1 POPS |
| SoC TDP | 950 W | 750 W |
| 랙당 가속기 수 | 96 | 48 |
| 랙 전력 | 167 kW | 64 kW |
| 스케일업 도메인 | 약 12,288 가속기 | 약 6,000 가속기 |
Microsoft 자체 블로그 밖의 제원은 StorageReview가 발표 자료를 분석한 내용에 따른 것이다. Microsoft는 전체 데이터시트를 공개하지 않았고, 더 자세한 내용은 11월 Ignite에서 밝히겠다고 했다.
야심이 드러나는 곳은 랙이다. 가속기 96개가 4개씩 들어간 트레이 24대에 담기고, 전체는 167 kW다. 호스트 프로세서와 메모리, 스토리지, 냉각이 각 트레이에 통합되면서 별도의 호스트 트레이는 없어졌다. 열부하의 80% 이상을 액체 냉각이 가져간다. 랙 내부 네트워크는 절반만 스위칭된 구조로, 같은 트레이의 가속기 두 개는 직결되고 스위치드 이더넷 패브릭이 96개 전부에 닿는다. 두 번째 계층은 광으로 최대 128개 랙을 묶어 최대 12,288 가속기 규모의 슈퍼포드를 만든다. 가속기는 호스트나 별도 NIC를 거치지 않고 전송을 개시할 수 있다. 커널에서 데이터센터까지 "소프트웨어에 하나의 통신 모델을 제시한다"는 Microsoft의 표현이 가리키는 부분은, 경쟁사가 선반에서 사올 수 있는 것이 아니다.
주장, 그리고 그 근거
Microsoft는 Maia 300이 "주요 GPU 기반 시스템"보다 메가와트당 토큰이 40% 많고, 랙 단위 토큰 처리량은 Maia 200의 최대 7배, 와트당 성능은 2.5배 이상이라고 밝혔다. 셋 모두 Microsoft 자신의 수치다. 40%라는 숫자는 비교 대상 GPU도, 모델도, 서빙 구성도 밝히지 않아 공개된 형태로는 검증이 불가능하다. 랙 단위 수치도 가속기 수를 두 배로 늘린 데서 나온 부분이 있다. 여기에 독립적인 벤치마크는 하나도 없다.
정직한 비교는 로이터가 제시한 쪽이다. 167 kW에 Maia 300 96개 대 142 kW에 GPU 72개인 Nvidia GB300 랙. Microsoft는 집적도를 사고 그 값을 랙당 전력으로 치르고 있다. 이것이 성립하려면 데이터센터와 버스바, 전력 배분 알고리즘까지 직접 갖고 있어야 한다 — Microsoft는 갖고 있다.
Microsoft가 이걸 하는 이유
Azure 하드웨어 시스템·인프라를 이끄는 Rani Borkar는 로이터에 목표가 "모든 와트, 모든 달러, 모든 바이트의 메모리마다 더 많은 지능을 내놓는 것"이라고 말했다. 작동하는 단어는 달러다. Microsoft는 올해 달력 연도 설비투자가 1,750억 달러를 넘을 것으로 보고 있고, 그중 상당 부분이 Nvidia로 간다. Maia 300은 "Microsoft 제품과 서비스의 주된 AI 추론 시스템"이 될 것이라고 설명된다 — Copilot, Microsoft 365, GitHub Copilot, Foundry다. Microsoft는 로이터에 내년에 Maia 300을 100만 개 이상 투입할 수 있다고 밝혔고, 멀티기가와트 규모 배치는 2027년에 시작된다.
주장하지 않은 것도 눈여겨볼 만하다. 학습용 플릿에는 Nvidia와 AMD가 남는다. Maia는 Azure 인스턴스 타입으로 팔리지 않으므로, 고객이 빌려서 직접 벤치마크를 돌릴 수는 없다. 이것은 Microsoft가 자신의 추론 비용을 GPU 시장에서 빼내는 움직임이고, 다른 회사의 수요를 가져오려는 움직임이 아니다.
그쪽이 범위는 좁지만 더 어려운 전략이다. 외판용 가속기는 Nvidia의 소프트웨어 생태계를 상대로 데이터시트에서 이겨야 한다. 자가용은 Microsoft 자신의 워크로드에서, Microsoft 자신의 전력 단가로, Microsoft 자신의 컴파일러 팀을 붙여 GPU를 이기면 된다 — 그리고 자사 워크로드는 수직 통합된 설계를 모델에 맞추고 모델을 설계에 맞출 수 있는 유일한 경우다. 40%가 사실인지는 여기서는 알 수 없다. HBM4 공급이 이토록 빡빡한 상황에서 1년에 100만 개를 정말 만들 수 있는지, Ignite가 답해야 할 질문은 그쪽이다.
Sources: Microsoft: Microsoft to expand Azure Maia system to multi-gigawatt deployments · Microsoft Azure: Deep dive into Azure Maia 300 architecture · Microsoft: Maia 300 newsroom · Reuters: Microsoft plans huge deployment of its own AI chips, with an eye on saving costs · StorageReview: Microsoft Maia 300 puts 288GB of HBM4 at 18TB/s on an N2P chiplet · HPCwire: Microsoft announces Maia 300, its next-gen custom AI chip