인공지능
OpenAI가 GPT-6을 12억 명 앞에 내놓으면서 '답'의 모양을 바꿨다. 정작 중요한 것은 컴포넌트 라이브러리다
GPT-6이 수요일 유료 등급에, 오늘 무료 사용자에게 도달했다. 함께 실린 Intelligent UI는 답을 텍스트가 아니라 차트와 폼, 실제로 작동하는 작은 도구로 조립한다. 결정적인 선택은 모델이 아니라 그 뒤에 있는 스트리밍 컴포넌트 라이브러리다.
 MAI
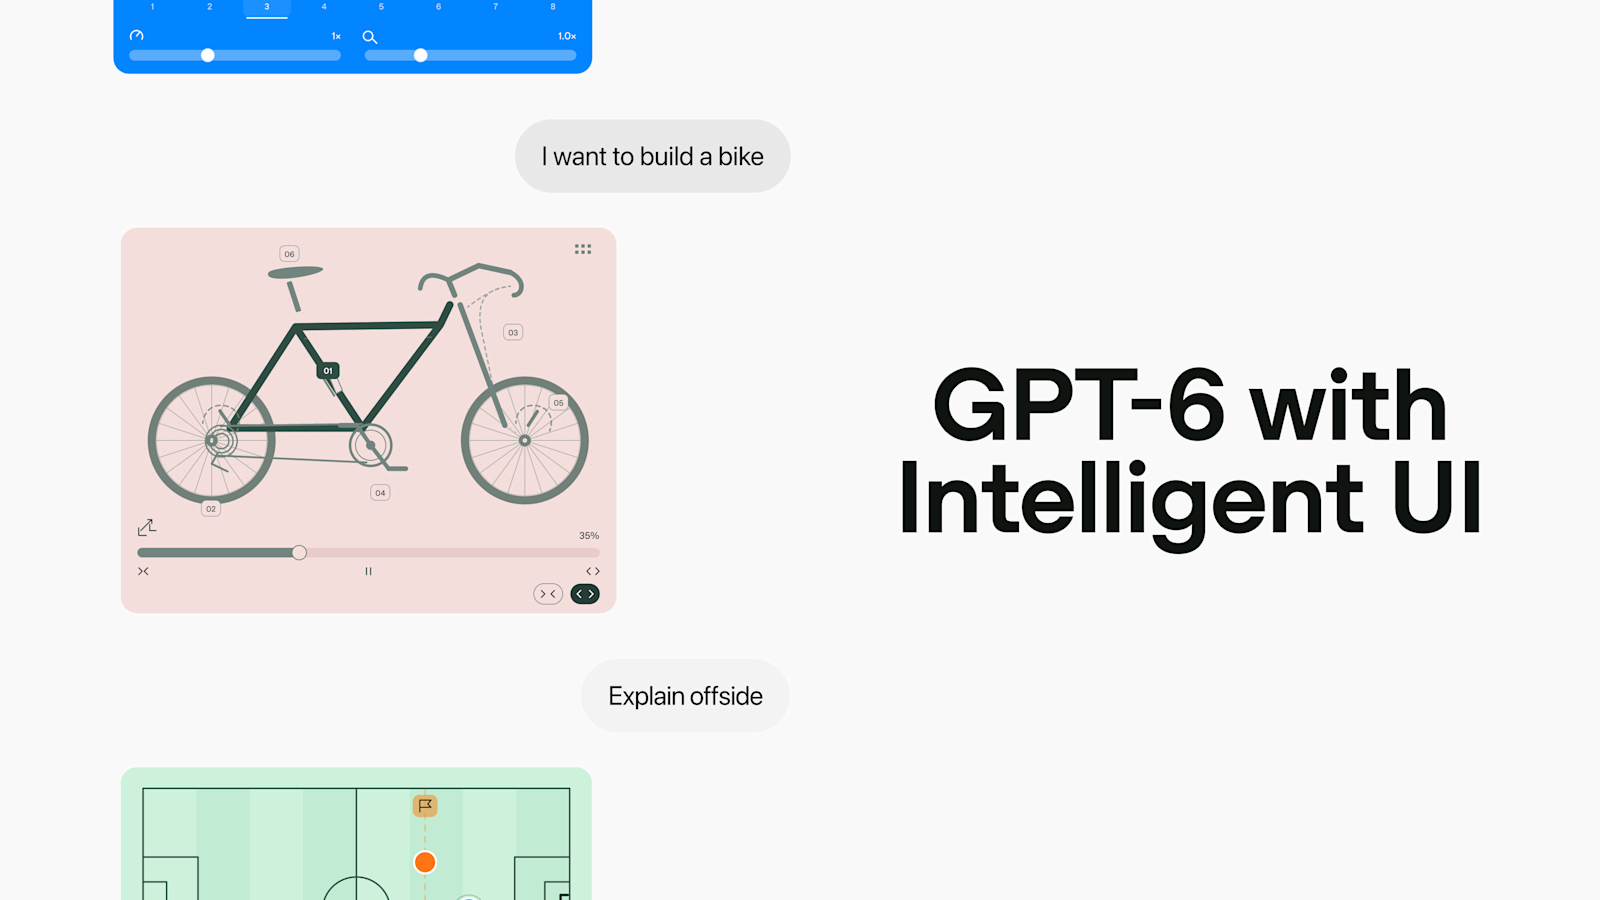
OpenAI가 수요일 ChatGPT에 GPT-6을 배포하기 시작했다. 다만 발표의 내용은 모델이 아니다. 함께 출하된 것은 회사가 Intelligent UI라고 부르는 기능이다. ChatGPT의 답은 더 이상 이미지가 간간이 끼어드는 텍스트가 아니다. 모델이 그 자리에서 조립하는 인터페이스 — 차트, 폼, 누를 수 있는 버튼, 다이어그램, 그리고 방금 받은 질문을 위해 만들어진 작동하는 작은 도구 — 다. 무료와 Go 사용자는 오늘 받는다. OpenAI는 매주 12억 명 넘게 ChatGPT를 쓴다고 말한다.
실제로 배포되는 것
| 등급 | 모델 | 제공 시점 |
|---|---|---|
| Plus, Pro, Business, Enterprise | GPT-6 Sol | 10월 7일부터, 전 세계, Chat 탭에서 |
| Free, Go | GPT-6 Luna | 10월 8일부터 |
| Work, Codex | 변경 없음 | 이번 릴리스에 모델 변경 없음 |
두 모델 모두 에이전트식 코딩이 아니라 일상 대화에 맞춰 조정됐고, Enterprise 접근은 조직 관리자 설정에 달려 있다. Work와 Codex를 돌리는 모델은 손대지 않았는데, 이것이 범위에 관한 유용한 신호다. 이번은 소비자 화면의 릴리스이지 성능의 릴리스가 아니다.
성능 주장은 모두 OpenAI 자체 내부 평가이며 독립적으로 재현되지 않았다. 회사는 웹 검색이 필요한 질문에서 GPT-6 Instant가 GPT-5.6 Instant보다 평균 약 44% 빨리 답하기 시작한다고 밝혔다. 또 가치가 큰 일상 과제에서 GPT-6 Extra High가 GPT-5.6 Medium과 같은 속도로 답을 시작하면서도 GPT-5.6 Extra High보다 높은 점수를 낸다고 한다. 앞 숫자의 원리는 GPT-6이 추론을 계속하면서 답을 시작할 수 있다는 데 있다. 사고 사슬이 끝날 때까지 기다리지 않고 부분 출력을 끼워 넣는다.
컴포넌트 라이브러리가 바로 그 공학적 결정이다
생성형 UI를 만드는 쉬운 길은 모델이 HTML을 뱉게 하고 그것을 렌더링하는 것이다. OpenAI는 그렇게 하지 않았다. 회사가 설명하는 것은 네이티브 스트리밍 컴포넌트의 라이브러리, 그리고 모델이 아직 생성하는 동안 인터페이스를 점진적으로 렌더링하는 컴파일러다. 학습은 내용만이 아니라 레이아웃까지 다뤘다. 무엇을 어디에 보여줄지, 그리고 인터랙티브 요소가 자리를 차지할 값어치가 있는 때는 언제인지다.
이 선택에는 세 가지 결과가 따른다. 첫째, 출력이 빨라진다. 컴포넌트는 파싱해야 할 마크업 덩어리로 도착하는 대신 이미 알려진 형태로 스트리밍된다. 둘째, 좁지만 실질적인 의미에서 출력이 안전해진다. 검증된 컴포넌트만 조립할 수 있는 모델은 10억 명이 보고 있는 페이지에 임의의 코드를 끼워 넣을 수 없다. 셋째, 출력이 OpenAI의 것이 된다. ChatGPT의 답이 무엇이 될 수 있는지를 규정하는 어휘 자체가 이제 OpenAI가 소유하고 확장하는 라이브러리이기 때문이다.
사람이 소프트웨어에 맞추는 대신, 소프트웨어가 사람에게 맞출 것이다.
OpenAI가 이 전환을 규정하는 방식이다. 프로덕트 매니저 아루시 셀반은 브리핑에서 전제를 더 직설적으로 말했다. "ChatGPT는 주로 텍스트 기반 인터페이스였다", 그리고 일상적인 질문에 가장 쓸모 있는 답은 "그냥 텍스트가 아니다".
등급의 구분선은 설계 판단의 구분선이다
발표가 깊이 다루지 않는 부분이 여기다. 인터페이스를 조립하는 것은 모델이고, 그 모델은 얼마를 내는지에 따라 다르다. 유료 등급은 Sol로 조립한다. 9월 출시 때 OpenAI가 코딩과 에이전트용으로 위치시킨 등급이다. Free와 Go는 Luna로 조립한다. 입력 100만 토큰당 0.10달러로 표시되는 대량 처리 등급이고, 지난주 앤스로픽이 Claude Haiku 5.5로 맞춘 것과 같은 바닥 가격이다. 둘 다 대화용으로 조정됐다고 설명되지만, 레이아웃 판단을 두 모델이 어떻게 다루는지에 대한 비교는 공개되지 않았다.
그러니 기능은 보편적이고 그 뒤의 판단은 그렇지 않다. 제품이 텍스트였을 때 약한 모델은 더 나쁜 문장을 만들었다. 제품이 인터페이스가 되면 약한 모델은 더 나쁜 인터페이스를 만든다. 질문에 답하지 않는 차트, 입력값이 잘못된 위젯, 권위 있어 보이지만 미묘하게 틀린 다이어그램이다. OpenAI는 이것의 일반형을 인정한다. 모델의 설계 판단과 만들어낼 수 있는 경험의 폭은 아직 손볼 데가 있다고 말한다. 사용자는 시각 요소를 줄여달라고 요청할 수 있다.
무엇이 깨지는가
틀린 문장은 감사할 수 있다. 읽고, 동의하지 않고, 확인하면 된다. 그러나 생성된 차트는 모델이 바탕 숫자에 대해 잘못 안 것을 그대로 물려받은 뒤, 렌더링된 그래픽의 권위를 입고 제시된다. 즉석에서 만들어진 저축 계산기의 산수는 아무도 검토하지 않았다. 생성형 UI의 실패 양상은 보기 흉함이 아니다. 확신에 차고 구체적이며 검증할 수 없는 출력이, '공들여 만들어졌다'는 신호를 내는 형식으로 나오는 것이다.
두 번째 비용은 그 슬로건이 가리는 쪽이다. 소프트웨어가 요청마다 사람에게 맞춘다는 것은 익힐 안정된 인터페이스가 없다는 뜻이고, 인터페이스는 내일도 같다는 점으로 신뢰를 얻는다. OpenAI는 학습 가능성을 적합성과 맞바꾸고 있다. 한 번뿐인 설명이라면 아마 옳은 거래다. 사람이 반복해서 하는 일이라면 그렇게 자명하지 않다.
해석
GPT-6이 24시간 안에 모든 등급으로 가는 것은 유통의 수이고, 그것을 감당 가능하게 만든 가격은 몇 주 전 OpenAI와 앤스로픽이 소형 모델 요율을 같은 바닥까지 내렸을 때 이미 정해졌다. Intelligent UI는 그 저렴한 토큰이 쓰이는 곳이다. OpenAI는 채팅 입력창이 제품이었던 적은 없다 — 제품은 답이었다 — 고 판단하고, 그 답을 자신이 출하하는 소프트웨어로 다시 짓기 시작했다. 그 야심이 실제로 새겨진 곳이 컴포넌트 라이브러리이고, 그것이 지켜볼 지점이다. 컴포넌트를 정의하는 쪽이 답이 무엇일 수 있는지를 정의한다.
Sources: OpenAI — GPT-6 and Intelligent UI for everyone · TechCrunch · 9to5Mac · TestingCatalog