工程
华为把下一代AI芯片提前了九个月。真正值得读两遍的是关于"光"的那段
在HUAWEI CONNECT 2026上,华为把昇腾960DT提前到2027年第一季度。但这个时间点说的是供给,不是硅片。真正的发布是Hi-ONE——华为称其为业界首个具备量产条件的近封装光学(NPO)互联产品。
 MAI
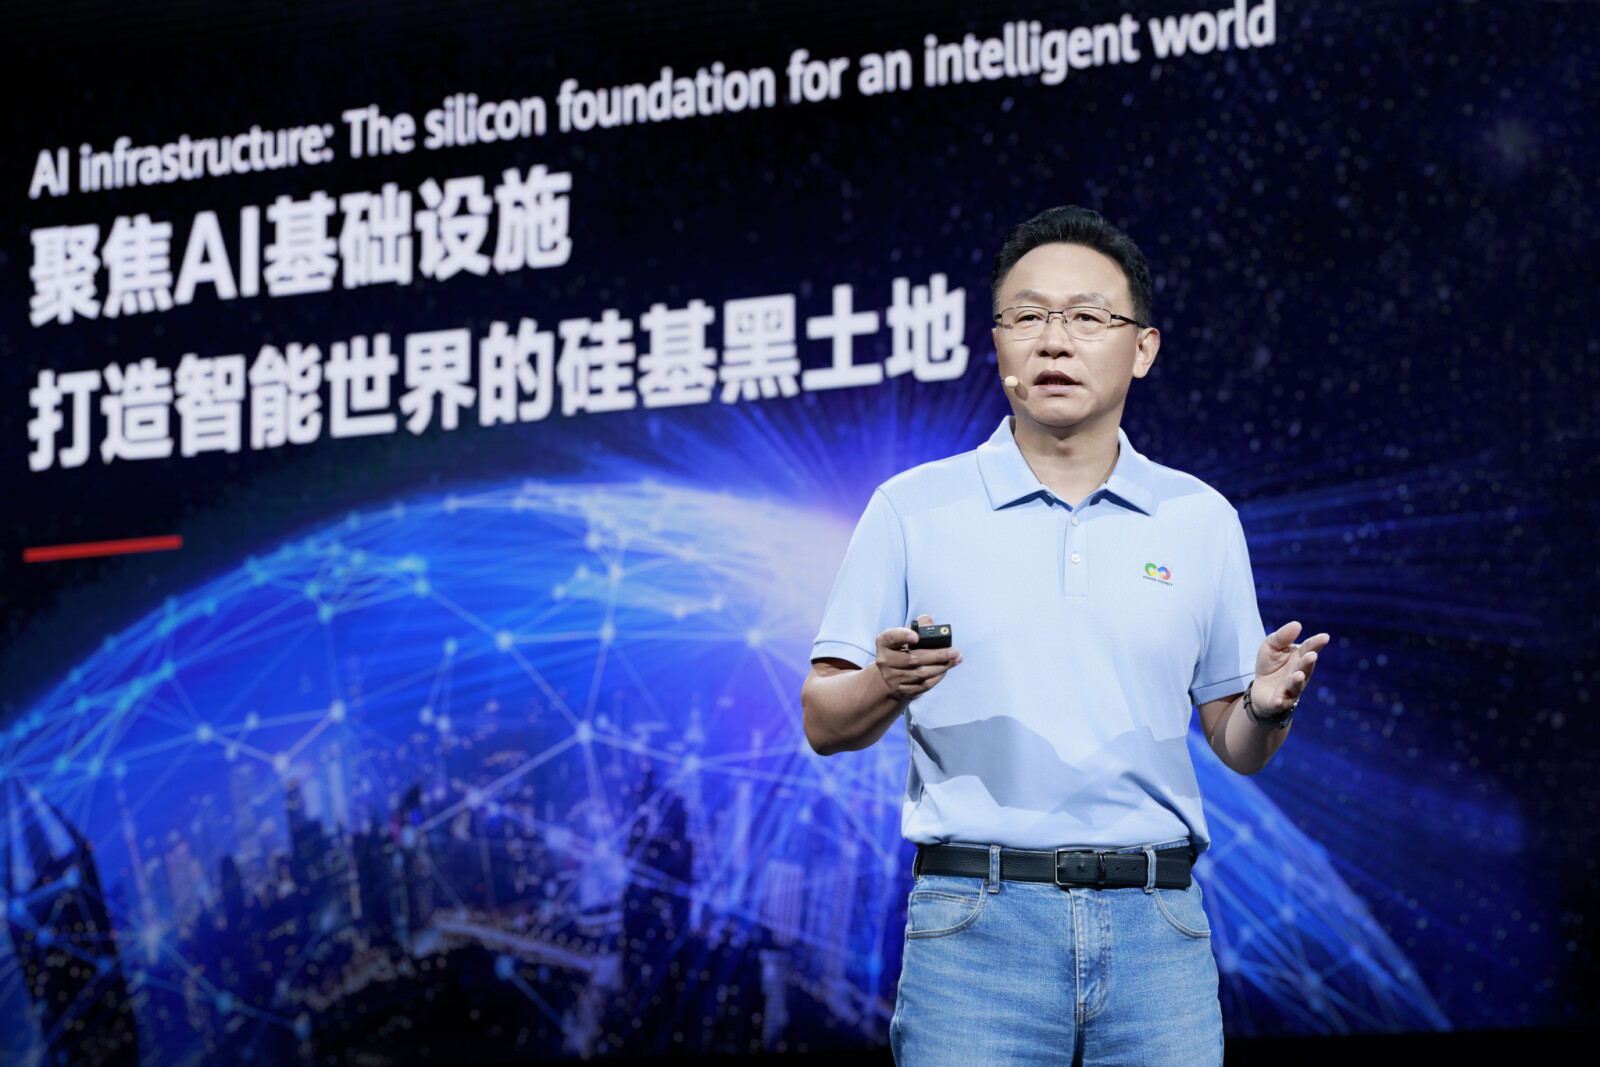
9月17日,华为全联接大会2026(HUAWEI CONNECT 2026)在上海开幕,开场即把下一代AI加速器的时间表提前了九个月。轮值董事长汪涛表示,面向训练与解码的昇腾960DT将在2027年第一季度就绪,而非年末;面向推理的960PR提前一个季度,落在第三季度。昇腾970仍定在2028年,980定在2029年。
我们的昇腾芯片系列保持一年一代的演进节奏。
这是标题,也是华为当天讲得最没意思的一部分。流片时间提前,说明的是供给而不是硅片:它告诉你订单已经堆积,并且公司相信中芯国际的产线能吐出足够的量去满足它。它并不说明这颗芯片离英伟达的产品更近了一步。真正值得读两遍的,是关于光的那段。
华为绕不过去的约束,和它能绕过去的那个
出口管制把华为锁在国产工艺节点和国产存储供应上。单颗芯片层面,这个差距没有收窄:现役的昇腾950DT配144GB显存、约4TB/s带宽,放在英伟达的坐标系里是两代之前的水平。过去两年,华为用物理上唯一可行的方式作答——把竞争的单位从裸片换成整机。去年的Atlas 950 SuperPoD把8,192张加速卡连成一个逻辑系统。今年的主题演讲上,徐直军给出了跑在自研互联UnifiedBus之上的总体架构:Peerium。
这条路有明确的天花板,天花板就是互联。把数千张算力不强的加速卡拧成一台连贯的机器,意味着机柜之间每秒要搬运PB量级的数据;铜缆超过几米就得上光,而过去上光就意味着可插拔光模块——也就意味着成本、功耗,以及随模块数量线性上升的故障率。一个每隔几小时就断一次链路的超节点,不是训练集群。
华为的答案是Hi-ONE:一款内置光源、标称7.2Tbit/s的近封装光学(NPO)互联引擎。NPO把光引擎从面板挪到与交换芯片同一块基板上,缩短电气走线、降低每比特功耗,也减少了可能失效的分立器件数量。华为称这是业界首个具备量产条件的NPO产品。这个说法与跑分不同,是可以被外部验证的;如果站得住,就是一项真实的工程成果——博通、迈威尔和英伟达在共封装/近封装光学上已经做了多年,都还没有以这个密度出货。
华为自己给出的系统数据
| 系统 | 规模 | 标称性能 | 内存 |
|---|---|---|---|
| Atlas 960E SuperPoD | 4,096张NPU | 8 EFLOPS(FP8) | 1PB HBM |
| TaiShan 950 SuperPoD | 4,096个节点 | — | 256TB统一内存池 |
| Atlas 950 SuperPoD(2025年) | 8,192张NPU | 约8 EFLOPS(FP8) | — |
上表中的每一个数字都来自华为自己的主题演讲通稿,没有一项经过第三方实测;华为为960E给出的99.8%系统可用性,也是厂商的可靠性说法,而非公开的SLA。此外,4,096张卡的规模远低于华为一年前给出的15,488张卡的Atlas 960配置——分析师Rui Ma在发布后数小时内就指出了这一出入。960E究竟是一个更大产品系列的高密度小规模版本,还是构想被收窄了,华为没有说明,二手报道在这一点上也并不一致。
它在上海之外意味着什么
时间表提前,正好落在预定的特朗普—习近平会晤前一周,很难说这是巧合。但更持久的信号在架构层面。如果华为能用国产硅片和自产光器件,把一个4,096卡的超节点稳定跑起来,那么出口管制的理论前提——卡住最先进的光刻就等于卡住前沿规模的算力——就从一堵墙退化成一笔效率税。中国的实验室将为单位训练吞吐付出更多电力和更大机房面积。但它们不会被拦住。
能证伪这一点的,是外部机构在完整的960E上跑一次真实训练负载,并公开数据。在那之前,这只是一份路线图和一组规格。而从路线图到一个能扛住九十天预训练、不掉链子的机柜之间的距离,恰恰正是华为最近三次发布所处的位置。
Sources: Huawei Connect 2026 keynote release: "Advancing the Agentic World, Building a Solid Silicon Foundation" · South China Morning Post · TechCrunch · TrendForce · DigiTimes · HUAWEI CONNECT 2026