工程
Maia 300 把算力加了 36%,把内存带宽翻了 2.5 倍。这个比例就是它的主张
微软在 OCP 全球峰会上发布的第三代自研 AI 加速器,算力比 Maia 200 高 36%,内存带宽则是它的 2.5 倍——这是一次明确的押注:推理的瓶颈不在算术,而在内存。而这颗芯片不会卖给 Azure 客户,这一点几乎已经说明了它的用途。
 MAI
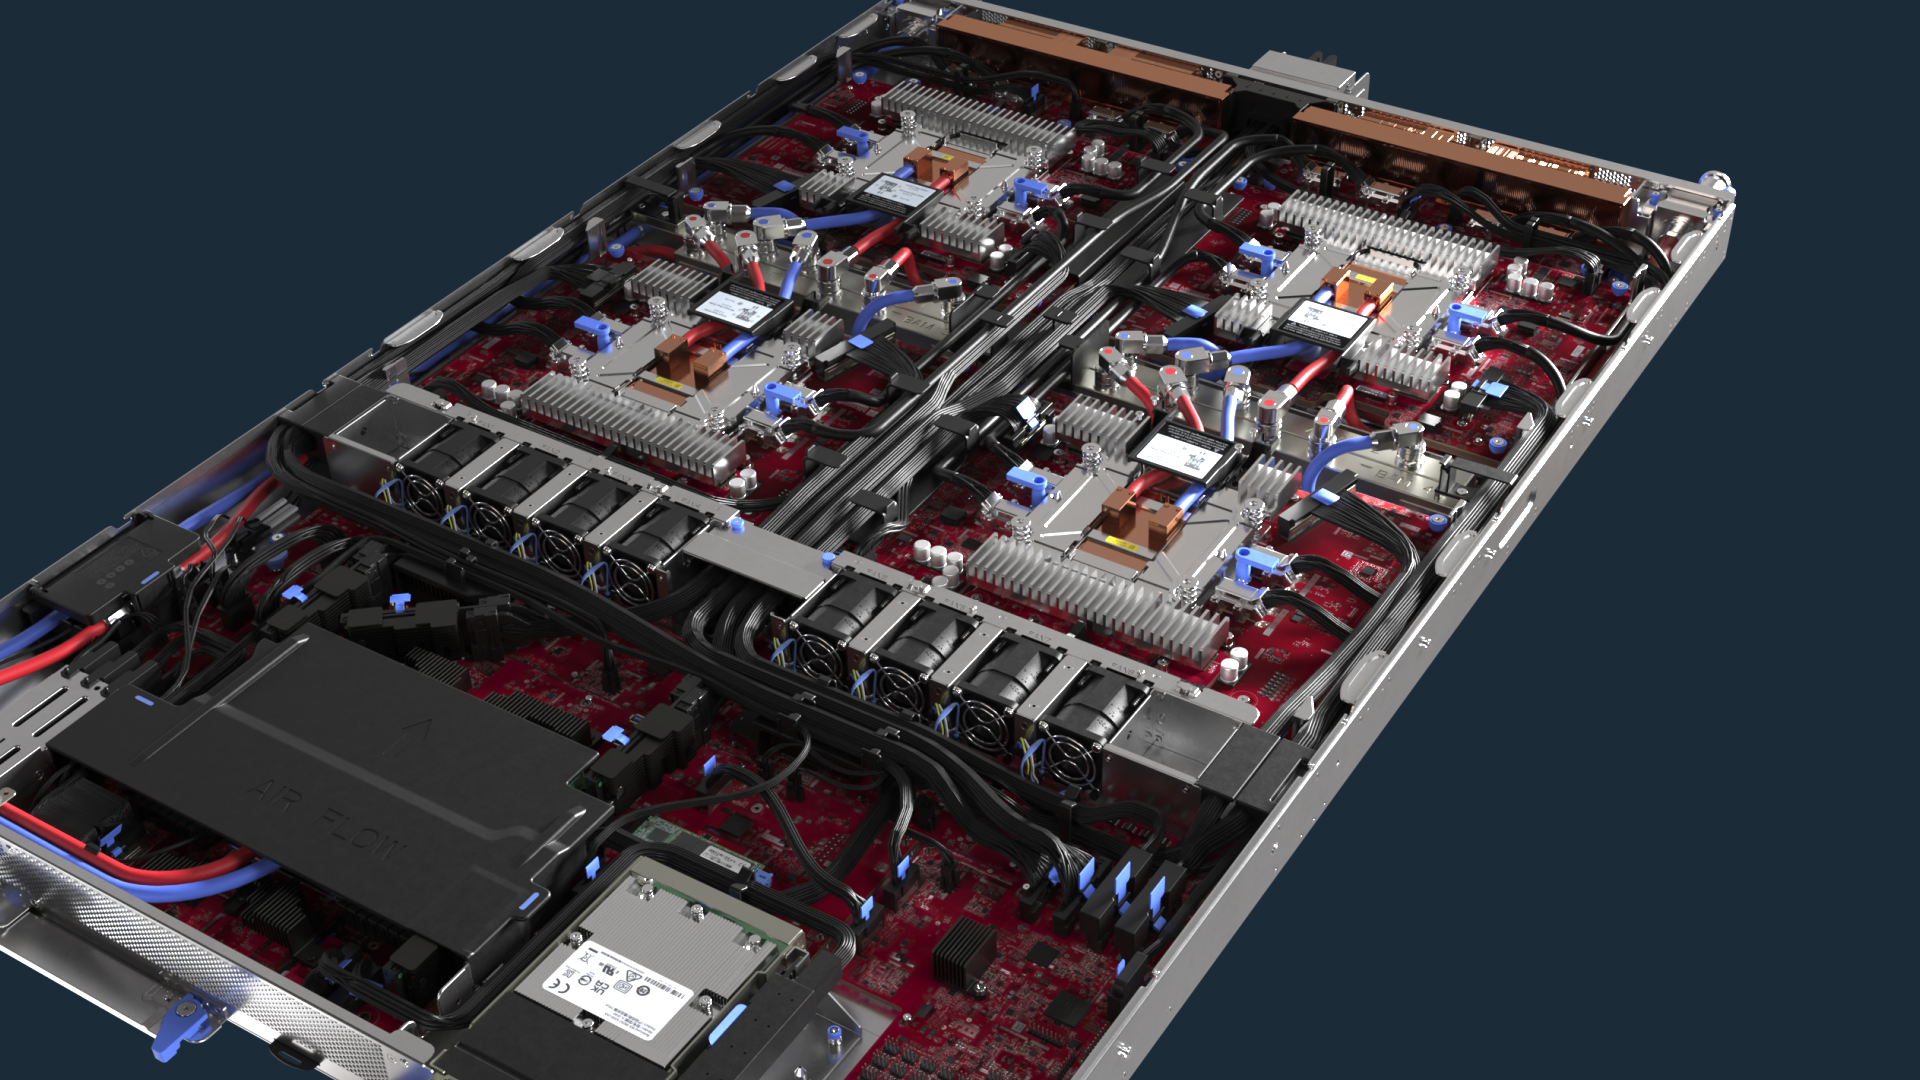
微软 10 月 12 日在 OCP 全球峰会上发布的第三代自研 AI 加速器,算力比它所取代的那一代高出 36%,内存带宽则是 2.5 倍。这两个数字在微软自己的材料里前后并列,而它们之间的差距,就是这颗芯片的设计。Maia 300 并不是想在乘法上压过 Nvidia。它押的是:挡在一座数据中心和更高每秒 token 数之间的,不是算术,而是把权重和 KV 缓存搬到算术单元面前的速度。
这个押注本身不新——过去三年高带宽内存一直是稀缺品,原因正在这里——但 Maia 300 是第一颗从平面布局阶段就围绕它来搭的 Maia。
硅片上变了什么
Maia 300 是微软第一颗多 chiplet 的 Maia。计算裸片转到台积电 N2P 工艺,内存控制器和 I/O 功能被拆到单独的裸片上;微软说这些裸片是按带宽和成本、而不是按密度来优化的。内存寻址从跨 chiplet 的 UMA 改为 NUMA,数据可以放在用它的计算单元旁边——这等于在结构上承认:在一颗铺这么开的芯片上,一个张量放在哪里,和它能被多快地乘起来一样重要。
| Maia 300 | Maia 200 | |
|---|---|---|
| 计算裸片 | 台积电 N2P,多 chiplet,I/O 与内存裸片分离 | N3P 单片 |
| HBM | 8 组 HBM4 — 288 GB,18 TB/s | 6 组 HBM3E — 216 GB,7.1 TB/s |
| FP4 峰值 | 13.8 POPS | 10.1 POPS |
| SoC TDP | 950 W | 750 W |
| 每机柜加速器数 | 96 | 48 |
| 机柜功率 | 167 kW | 64 kW |
| 纵向扩展域 | 约 12,288 个加速器 | 约 6,000 个加速器 |
微软自家博客之外的规格,来自 StorageReview 对发布材料的解读;微软没有公开完整规格书,并表示更多细节要等 11 月的 Ignite。
野心体现在机柜上。96 个加速器装进 24 个四加速器托盘,整柜 167 kW;主机处理器、内存、存储和散热都收进每个托盘,独立的主机托盘被取消。液冷带走八成以上的热负荷。柜内网络是半交换结构:同一托盘里的两个加速器直连,一张交换式以太网 fabric 覆盖全部 96 个。第二层用光互连最多 128 个机柜,组成最多 12,288 个加速器的 superpod;加速器可以不经过主机或独立网卡发起传输。微软那句从内核到数据中心"向软件呈现同一个通信模型"所指的部分,是竞争对手没法从货架上买到的。
这些说法,以及它们的依据
微软称 Maia 300 每兆瓦产出的 token 比"领先的 GPU 系统"多 40%,机柜级 token 吞吐最高是 Maia 200 的七倍,每瓦性能超过 2.5 倍。三个数字都是微软自己的。40% 这个数字没有点明对比的 GPU、模型或服务配置,按公开的样子根本无法被检验;机柜级的数字也有一部分来自把加速器数量翻倍。这里没有任何一项经过独立基准测试。
更诚实的对比是路透社摆出来的那组:167 kW 装 96 个 Maia 300,对上 Nvidia GB300 机柜的 142 kW 装 72 块 GPU。微软买的是密度,代价付在每机柜的功率上。这笔账能算得通,前提是你同时拥有数据中心、母线和功率分配算法——微软拥有。
微软为什么要做这件事
负责 Azure 硬件系统与基础设施的 Rani Borkar 对路透社说,目标是"让每一瓦、每一美元、每一字节内存都交付更多智能"。起作用的那个词是美元。微软预计本日历年资本支出将超过 1,750 亿美元,其中相当一部分流向 Nvidia。Maia 300 被描述为将成为"微软产品与服务的主要 AI 推理系统"——Copilot、Microsoft 365、GitHub Copilot、Foundry。微软告诉路透社,明年可能部署超过一百万颗 Maia 300,多吉瓦级部署从 2027 年开始。
也要注意它没有宣称什么。训练集群里 Nvidia 和 AMD 都留着。Maia 不作为 Azure 实例类型出售,所以没有客户能租一台来跑自己的基准测试。这是微软把自己的推理账单从 GPU 市场上摘下来,而不是去抢别人的生意。
那是范围更窄、但更难的一条路。对外销售的加速器,必须在规格表上正面战胜 Nvidia 的软件生态。自用的那一颗,只需要在微软自己的负载上、按微软自己的电价、由微软自己的编译器团队盯着,赢过 GPU——而自家负载正是垂直整合唯一能两头调的场合:设计可以迁就模型,模型也可以迁就设计。40% 是否成立,从这里无法判断。在 HBM4 供应如此紧张的情况下,微软能否在一年内造出一百万颗,才是 Ignite 该回答的问题。
Sources: Microsoft: Microsoft to expand Azure Maia system to multi-gigawatt deployments · Microsoft Azure: Deep dive into Azure Maia 300 architecture · Microsoft: Maia 300 newsroom · Reuters: Microsoft plans huge deployment of its own AI chips, with an eye on saving costs · StorageReview: Microsoft Maia 300 puts 288GB of HBM4 at 18TB/s on an N2P chiplet · HPCwire: Microsoft announces Maia 300, its next-gen custom AI chip