エンジニアリング
Maia 300は演算を36%、メモリ帯域を2.5倍にした。この比率こそが設計の主張である
OCP Global Summitで公開されたMicrosoftの第3世代カスタムAIアクセラレータは、Maia 200に対して演算性能を36%、メモリ帯域を2.5倍に引き上げた。推論を律速するのは演算ではなくメモリだという明確な賭けである。そしてこのチップはAzureの顧客には売られない——その一点が、用途をほぼ語っている。
 MAI
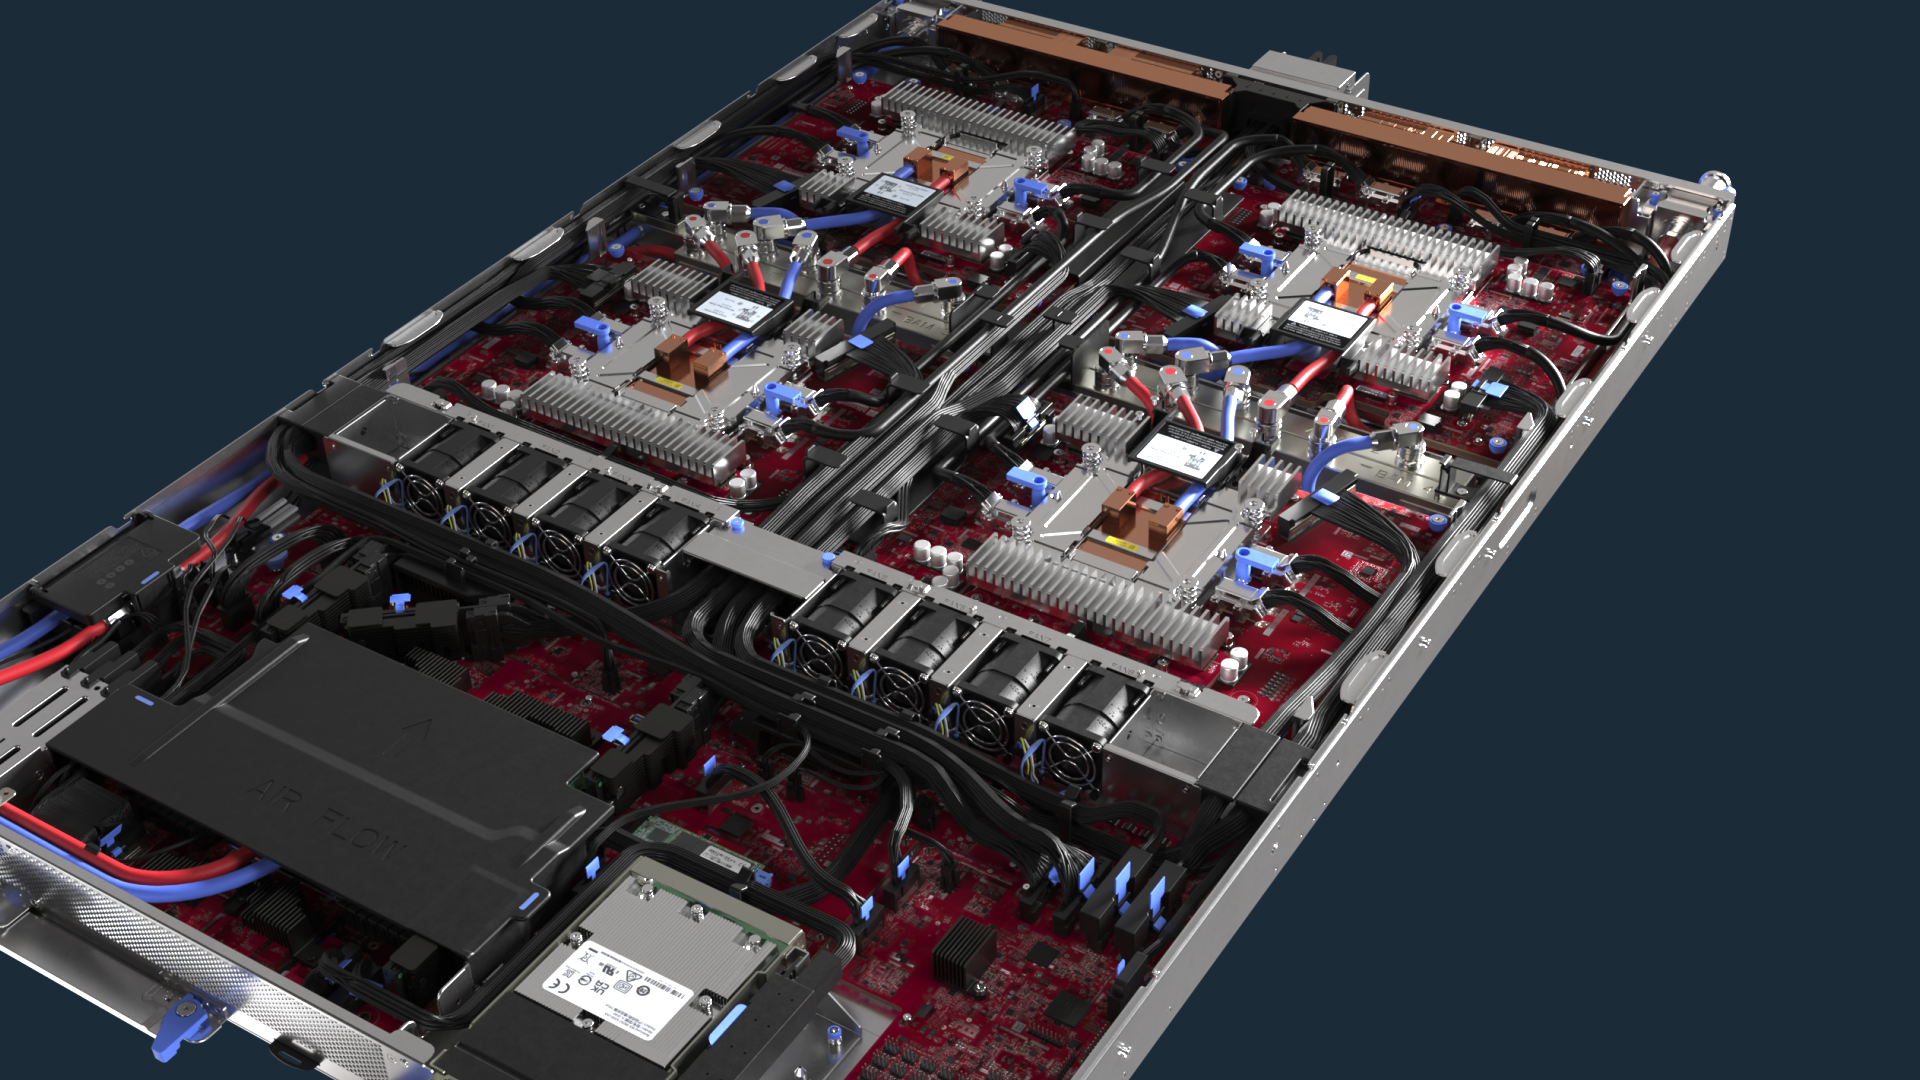
10月12日のOCP Global Summitで発表されたMicrosoftの3世代目のカスタムAIアクセラレータは、置き換える前世代に対して演算性能が36%増え、メモリ帯域は2.5倍になった。この2つの数字はMicrosoft自身の資料に並んで書かれており、その差こそが設計そのものである。Maia 300は、Nvidiaを演算量で上回ろうとする試みではない。データセンターと毎秒のトークン数のあいだに立ちはだかっているのは演算ではなく、重みとKVキャッシュを演算器の前に運び込む速度だという賭けである。
この賭け自体は新しくない——過去3年、高帯域メモリが希少品であり続けた理由がまさにそれだ——が、Maia 300はフロアプランの段階からそれを中心に組まれた最初のMaiaである。
シリコンで何が変わったか
Maia 300はMicrosoft初のマルチチップレット構成のMaiaである。演算ダイはTSMCのN2Pプロセスに移り、メモリコントローラとI/Oの機能は別ダイに分けられた。Microsoftは、これらのダイは密度ではなく帯域とコストに最適化したと説明している。メモリのアドレッシングはチップレットをまたぐUMAからNUMAへ移り、データを使う演算器の近くに置けるようになった。これだけ横に広い部品では、テンソルがどこに置かれているかが、どれだけ速く掛けられるかと同じくらい効くという、構造的な認識の表明である。
| Maia 300 | Maia 200 | |
|---|---|---|
| 演算ダイ | TSMC N2P、I/Oダイとメモリダイを分けたマルチチップレット | N3Pのモノリシックダイ |
| HBM | HBM4を8スタック — 288 GB、18 TB/s | HBM3Eを6スタック — 216 GB、7.1 TB/s |
| FP4ピーク | 13.8 POPS | 10.1 POPS |
| SoC TDP | 950 W | 750 W |
| ラック当たりアクセラレータ数 | 96 | 48 |
| ラック消費電力 | 167 kW | 64 kW |
| スケールアップ領域 | 約12,288アクセラレータ | 約6,000アクセラレータ |
Microsoft自身のブログ以外の仕様は、StorageReviewが発表資料を読み解いたものによる。Microsoftは完全なデータシートを公開しておらず、詳細は11月のIgniteで示すとしている。
野心が見えるのはラックである。96基のアクセラレータが4基入りのトレイ24台に収まり、全体で167 kW。ホストプロセッサ、メモリ、ストレージ、冷却は各トレイに統合され、独立したホストトレイは廃された。熱負荷の80%超を液冷が運び出す。ラック内のネットワークは半スイッチ構成で、同じトレイのアクセラレータ2基は直結され、スイッチドEthernetファブリックが96基すべてに届く。第2階層は光で最大128ラックを結び、最大12,288アクセラレータのスーパーポッドを作る。アクセラレータはホストや独立したNICを介さずに転送を開始できる。カーネルからデータセンターまで「ソフトウェアに対して単一の通信モデルを提示する」というMicrosoftの表現が示す部分は、競合が棚から買えるものではない。
主張と、その裏付け
MicrosoftはMaia 300について、「主要なGPUベースのシステム」に対して1メガワット当たりのトークン数が40%多い、ラック規模のトークンスループットはMaia 200の最大7倍、電力当たり性能は2.5倍超だとしている。いずれもMicrosoft自身の数字である。40%という数字は比較対象のGPU、モデル、サービング構成のいずれも示しておらず、公開された形では検証不能だ。ラック規模の数字も、アクセラレータ数を倍にしたことによる部分がある。ここに独立したベンチマークは一つもない。
誠実な比較はロイターが示したものだ。167 kWに96基のMaia 300に対し、NvidiaのGB300ラックは142 kWに72基のGPU。Microsoftは密度を買い、その代価をラック当たりの電力で払っている。これが成り立つのは、データセンターとブスバー、そして電力配分アルゴリズムまで自分で持っている場合だけだ——Microsoftは持っている。
なぜMicrosoftはこれをやるのか
Azureのハードウェアシステムとインフラを率いるRani Borkarはロイターに対し、目標は「1ワット、1ドル、1バイトのメモリごとに、より多くの知能を届けること」だと語った。効いているのはドルである。Microsoftは今暦年の設備投資が1,750億ドルを超える見込みで、その相当部分がNvidia向けだ。Maia 300は「Microsoftの製品とサービスにおける主要なAI推論システム」になるとされている——Copilot、Microsoft 365、GitHub Copilot、Foundryである。Microsoftはロイターに、来年には100万個を超えるMaia 300を投入し得ると述べた。マルチギガワット規模の展開は2027年から始まる。
主張されていないことにも注意したい。学習用のフリートにはNvidiaとAMDが残る。MaiaはAzureのインスタンスタイプとして売られないので、顧客が借りて自分でベンチマークを回すことはできない。これはMicrosoftが自社の推論費用をGPU市場から外す動きであって、他社の需要を取りに行く動きではない。
そちらのほうが対象は狭いが、難しい戦略である。外販のアクセラレータは、Nvidiaのソフトウェアエコシステムを相手にデータシートで勝たなければならない。自家用のそれは、Microsoft自身のワークロードで、Microsoft自身の電力価格のもと、Microsoft自身のコンパイラチームを張り付けて、GPUに勝てばよい——そして自社ワークロードは、垂直統合された設計をモデルに合わせ、モデルを設計に合わせられる唯一の場面だ。40%が本当かは、ここからでは分からない。HBM4の供給がこれだけ逼迫しているなかで、1年に100万個を本当に作れるのか。Igniteが答えるべき問いはそちらである。
Sources: Microsoft: Microsoft to expand Azure Maia system to multi-gigawatt deployments · Microsoft Azure: Deep dive into Azure Maia 300 architecture · Microsoft: Maia 300 newsroom · Reuters: Microsoft plans huge deployment of its own AI chips, with an eye on saving costs · StorageReview: Microsoft Maia 300 puts 288GB of HBM4 at 18TB/s on an N2P chiplet · HPCwire: Microsoft announces Maia 300, its next-gen custom AI chip